想搭建一个 AI 聊天助手、企业知识库,或者能自动整理资料的 AI Agent,很多人遇到的第一个问题就是:是不是必须先买一台 GPU 服务器?
不一定。如果云服务器负责运行 AI 应用和工作流,大模型通过外部 API 调用,就不需要为了模型推理给这台服务器配 GPU。只有把模型推理也放到自己管理的机器上,才需要进一步评估模型大小、内存、显存和速度。
n8n、Dify、Open WebUI、Ollama 经常出现在同一份部署方案里,但它们承担的工作并不相同。先把应用运行在哪里、模型运行在哪里分清楚,才能判断普通云服务器够不够用。
一、自建 AI 应用与自建大模型推理有什么区别?
一个 AI 系统可以拆成三个部分。
| 部分 | 主要工作 | 配置重点 |
|---|---|---|
| 应用与工作流 | 提供网页、账号、聊天记录、任务编排和工具调用 | CPU、内存、任务并发与网络 |
| 模型推理 | 根据输入生成回答,或完成其他模型计算 | 模型规格、计算性能、内存或显存 |
| 数据与检索 | 保存文件、数据库、向量索引和运行记录 | 磁盘容量、读写性能、备份与检索负载 |
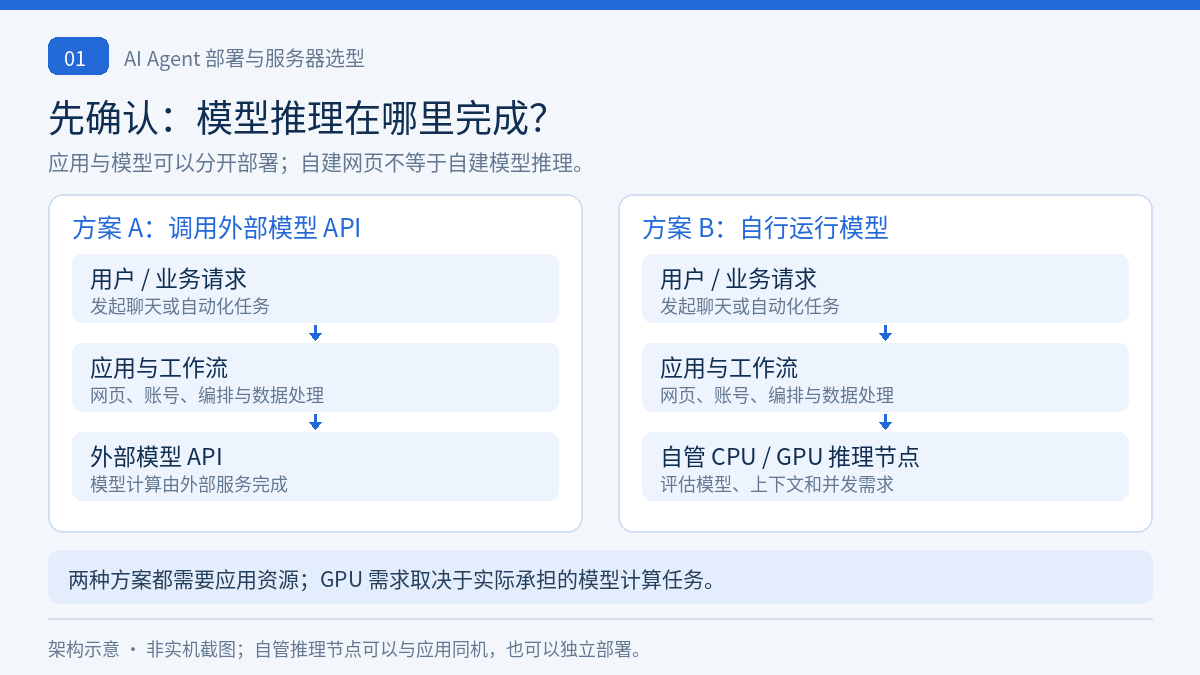
这三部分可以部署在同一台机器,也可以分别部署。
例如,普通云服务器运行 Dify,模型请求发送给外部 API,文件和数据库保存在自己的服务器中。此时,你自建的是应用平台,模型推理由外部服务完成。
如果在自己的 GPU 主机上通过 Ollama 运行本地模型,再让 Dify 连接它,模型推理也进入了自己管理的基础设施。
这里的“本地推理”是指模型运行在自己管理的设备上,可以是本地电脑,也可以是租用的服务器,不一定要与应用放在同一台机器。
二、n8n、Dify、Open WebUI 和 Ollama 分别做什么?
选择工具之前,先确认自己需要解决的问题。
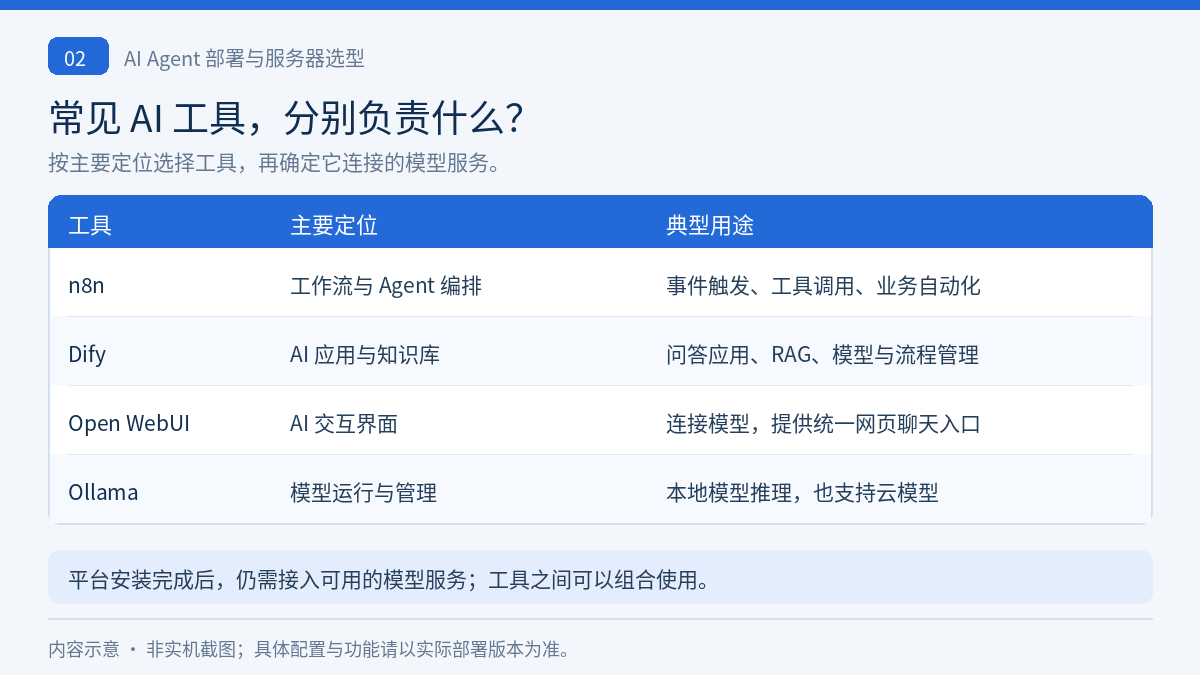
| 工具 | 主要定位 | 典型使用场景 |
|---|---|---|
| n8n | 工作流自动化与 AI Agent 编排 | 接收事件、调用模型、处理数据,再对接业务系统 |
| Dify | AI 应用开发平台 | 知识库问答、聊天应用、Agent 和多步骤 AI 工作流 |
| Open WebUI | 自托管 AI 交互界面 | 通过网页使用连接的模型,统一聊天入口 |
| Ollama | 模型运行与管理工具 | 在自己的设备上加载、运行本地模型并提供接口 |
它们的功能存在重叠,上表用于说明主要定位,不是绝对边界。
安装 n8n、Dify 或 Open WebUI,并不意味着服务器已经具备某个大模型的推理能力。 还需要连接模型服务,或者另外部署本地推理程序。
Ollama 也提供云模型相关功能。因此,看到项目里使用了 Ollama,仍需确认所选模型到底在本机运行,还是由云端提供推理。
如果想了解聊天机器人应用如何接入模型服务,可以参考本站的 AstrBot AI 聊天机器人部署文章。选型时,应分别确认应用平台和模型服务的要求。
三、调用模型 API,普通云服务器需要什么配置?
如果大模型通过外部 API 调用,云服务器主要承担应用、数据库、文件处理和任务调度等工作。
这类部署通常可以从满足应用要求的普通云服务器起步,但不能只看“能不能打开管理页面”。
1. 内存要覆盖整套服务
有些 AI 平台除了网页和 API 服务,还会运行数据库、缓存、后台任务、插件服务和向量数据库。它们都会占用内存。
以本文编写时 Dify 的 Docker Compose 官方文档为例,列出的最低硬件要求为 2 核 CPU、4 GiB 内存。这是部署平台的最低要求,不包含运行任意本地大模型的资源,也不代表某个并发量的性能承诺。
如果同时导入文档、运行多个工作流或部署其他应用,需要根据实际负载增加余量。其他项目也应分别查看自己的官方要求,不能直接照搬这组配置。
2. CPU 仍会影响使用体验
调用外部 API 不等于本机没有计算任务。文件解析、OCR、数据转换、代码执行和批量任务,都可能消耗 CPU;如果这些环节使用了本地模型,还要单独计算它们的资源需求。
例如,聊天页面运行正常,不代表同时导入大量扫描版 PDF 时仍然流畅。
3. 网络要同时覆盖用户和模型服务
服务器既需要接受用户请求,也需要访问模型 API、插件接口或其他业务系统。
选地域时,应分别测试用户到应用、应用到模型服务这两段连接。网页打开很快,并不能证明模型接口响应也快。
4. 磁盘要为长期数据留空间
除了程序文件,还应计入上传文档、数据库、向量索引、执行记录、日志和备份。
如果准备在莱卡云 Linux 云服务器上部署,可以先确定应用平台和模型调用方式,再按对应的服务清单评估配置。对于调用外部模型 API 的应用,没有必要仅因为名称里带有“AI”,就默认选择 GPU 服务器。
四、用 Ollama 运行本地模型,为什么不能只看参数量?
本地模型能否运行,以及运行起来是否好用,需要同时检查几个条件。
1. 模型权重只是资源占用的一部分
可以用下面的公式粗略估算权重本身的数据量:
权重数据量(字节)≈ 参数数量 × 每个参数的位数 ÷ 8假设一个模型有 80 亿个参数,所有参数都按 4 bit 存储,纯权重数据量约为 40 亿字节,即 4 GB,约 3.73 GiB。
这只是简化计算,不能据此得出“4GB 显存一定能运行这个模型”。 实际量化格式还有元数据、部分更高精度的张量等开销,运行时也需要额外空间。
2. 长上下文会增加内存需求
多轮对话、长文档、工具返回结果和代码文件,会占用上下文空间。模型运行时保存上下文相关状态,也需要内存或显存。
因此,同一个模型处理一小段文字和处理很长的材料,资源需求可能不同。判断配置是否足够时,应使用接近实际业务长度的输入。
3. 并发不能用单次演示代替
一条请求可以完成,不代表同时处理多条请求时仍能维持相同速度。并发会影响缓存、内存占用、排队时间和吞吐量。
对于 AI Agent,还要考虑一个任务可能包含多次模型调用、工具调用和重试。评估时应记录整个任务的耗时,而不只是一次模型回答的速度。
4. 有 GPU,也要确认能够被使用
显卡型号、驱动、推理后端支持情况,以及容器是否获得 GPU 访问权限,都会影响实际运行结果。
普通 CPU 也可以运行部分模型,但是否适合业务,要看响应速度、模型大小和并发要求。用于个人实验与用于多人交互服务,验收标准应当不同。
五、API 接入和本地模型,应该怎么选?
可以先按任务需要判断,再用实际数据验证。
| 需求 | 可以优先评估的方案 | 需要确认的条件 |
|---|---|---|
| 快速验证聊天助手或自动化流程 | 自建应用,调用模型 API | 接口功能、数据处理规则、限额和网络可达性 |
| 使用量还不稳定,经常更换模型 | 应用与模型服务分离 | 接口兼容性及迁移成本 |
| 要求模型计算在自己管理的环境完成 | 自建模型推理 | 模型能力、硬件支持和实际吞吐量 |
| 长期稳定的大量请求 | 比较 API 与自建推理的总成本 | 硬件利用率、并发、维护成本及服务质量 |
| 普通任务与敏感任务要求不同 | 按任务使用不同模型入口 | 明确哪些数据允许发送到哪个服务 |
自建应用与自建推理可以分开扩容。例如,普通云服务器负责登录、工作流和数据库,独立 GPU 节点负责推理。
这种架构需要处理两台机器之间的访问控制、网络和故障恢复,但也方便分别调整应用资源与推理资源。
成本比较也应采用相同的任务标准:回答质量、上下文长度、工具调用能力和响应时间接近,比较结果才有意义。
调用 API 时,要计入输入输出用量、重复调用、重试,以及可能使用的嵌入、重排或语音服务。自建推理时,则要计入计算资源、存储、备份、维护和空闲容量。
不能仅凭“软件可以自行部署”,就认定整个 AI 系统没有持续成本。
六、部署后,怎样判断瓶颈在哪里?
先确认慢的是页面加载、文档处理、模型首次输出,还是整个 Agent 任务,再检查对应服务。
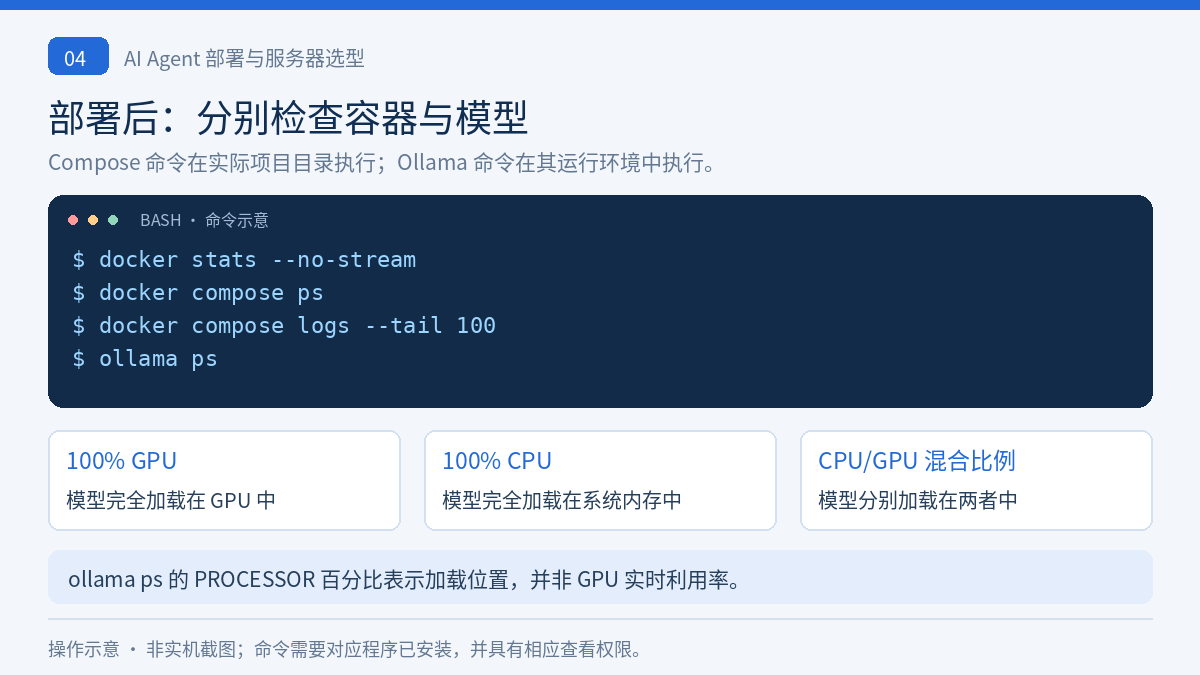
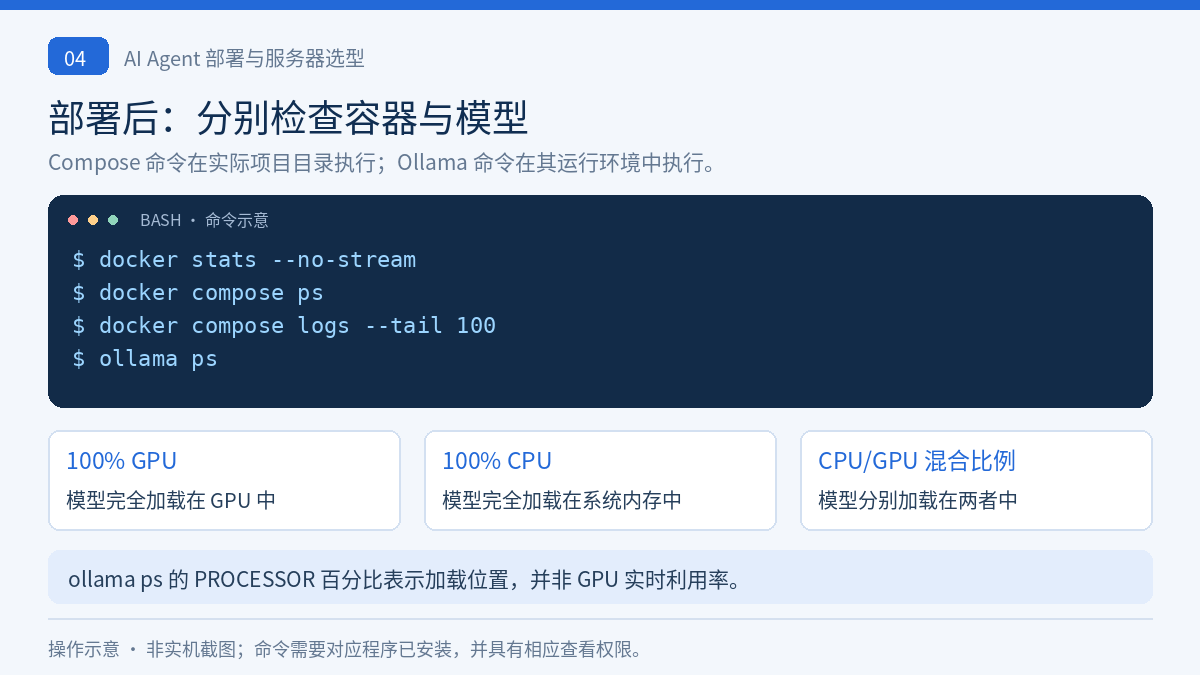
如果应用通过 Docker 部署,可以在有 Docker 操作权限的终端查看运行容器的资源快照:
docker stats --no-stream进入项目实际使用的 Compose 文件所在目录后,再检查服务状态和近期日志:
docker compose ps
docker compose logs --tail 100
重点观察是否出现内存不足、任务堆积、接口限流、网络超时或持续重启。对外提供日志前,先检查其中是否包含 API 密钥、用户输入或业务数据。
如果使用 Ollama 本地模型,在运行 Ollama 的环境中查看:
ollama psPROCESSOR 列说明模型加载的位置:
100% GPU:模型完全加载在 GPU 中。100% CPU:模型完全加载在系统内存中。CPU/GPU混合比例:模型分别加载在两者中。
这里的百分比不是 GPU 实时利用率。 如果没有显示模型,先确认目标本地模型正在运行或仍保留在内存中。
Docker 的内存统计也不等于显存统计,不能只看一处数值就判断 GPU 是否足够。
如果服务设置了资源限制,还要检查容器可用资源是否低于宿主机总资源。相关方法可以参考本站的《Docker Compose 如何限制 CPU 和内存?容器资源限制教程》。
建议用同一组任务,分别记录单用户和目标并发下的结果:
| 观察项 | 记录内容 |
|---|---|
| 响应速度 | 首次输出等待时间、整个任务完成时间 |
| 稳定性 | 超时、重试、失败和排队情况 |
| 资源 | CPU、内存,以及本地推理使用的显存 |
| 输出质量 | 回答是否正确、工具调用是否完成、格式是否符合要求 |
| 使用成本 | API 实际用量,或自建资源的占用与利用情况 |
这些结果比单纯比较服务器核数或模型参数量,更能说明方案是否适合实际使用。
七、自建 AI 时容易忽略的三个问题
1. 应用在自己的服务器上,数据就一定不会外发吗?
不一定。聊天模型、嵌入模型、重排服务、OCR、联网搜索或插件,都可能连接外部服务。
需要检查实际配置和调用流程,确认每个环节会把哪些内容发送到哪里。仅把网页和数据库部署在自己的服务器上,不能证明整个处理过程都在本地完成。
2. 有知识库,就必须自己训练大模型吗?
通常不必。常见的 RAG 知识库会先检索相关资料,再把资料与问题一起提供给模型生成回答。
这与重新训练模型是不同的工作。它仍需要文档解析、索引和检索资源;如果嵌入或重排也采用本地模型,这部分计算需求应单独评估。
3. 网页能打开,就算部署完成了吗?
还需要验证账号访问、模型调用、任务执行、数据保存和恢复流程。
正式使用前,应配置合适的访问权限,保护模型服务入口和 API 密钥,并确认数据库、上传文件及必要配置可以恢复。不要只备份容器镜像,却遗漏真正保存业务数据的目录或数据卷。
八、结语
部署 AI Agent 是否需要 GPU,取决于模型推理在哪里完成。
调用外部模型 API 时,普通云服务器可以负责应用和工作流,配置重点是整套服务的 CPU、内存、存储与网络。自行运行本地模型时,则需要进一步评估权重、上下文、并发、硬件支持和实际速度。
先用一组真实任务验证效果,记录资源占用与成本,再决定是否增加 GPU 或拆分推理节点。把应用需求和模型计算分开评估,才能为 AI 系统选择合适的服务器配置。