1. Docker healthcheck 是什么?
运行 Docker 容器时,我们经常通过:
docker ps查看容器状态。
例如:
Up 5 minutes很多人看到 Up 就认为应用已经能够正常提供服务。
实际上:
容器正在运行,并不等于容器内部的应用一定正常。
例如一个 Web 容器的主进程还在运行,但可能已经出现:
数据库连接失败;
接口无法响应;
应用初始化失败;
依赖服务不可用;
内部端口没有正常提供服务。
Docker 的 healthcheck 就是用来进一步判断:
容器内部的应用是否真正处于健康状态。
配置完成以后,容器可能出现:
starting
healthy
unhealthy
等健康状态。
2. Running 和 healthy 有什么区别?
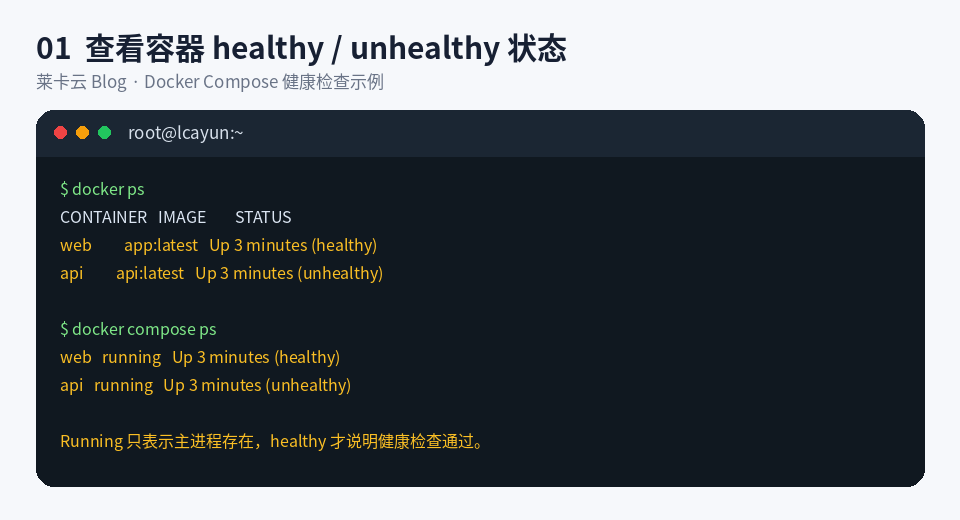
例如执行:
docker ps可能看到:
web Up 3 minutes (healthy)这里:
Up 3 minutes
表示容器主进程正在运行。
healthy
表示 Docker 设置的健康检查命令已经通过。
另一个容器可能显示:
api Up 3 minutes (unhealthy)这说明:
容器主进程仍然存在,但连续多次健康检查失败。
因此在实际项目中:
Running 更偏向“进程还活着”,healthy 更偏向“应用真的能正常工作”。
3. Docker Compose healthcheck 基本配置
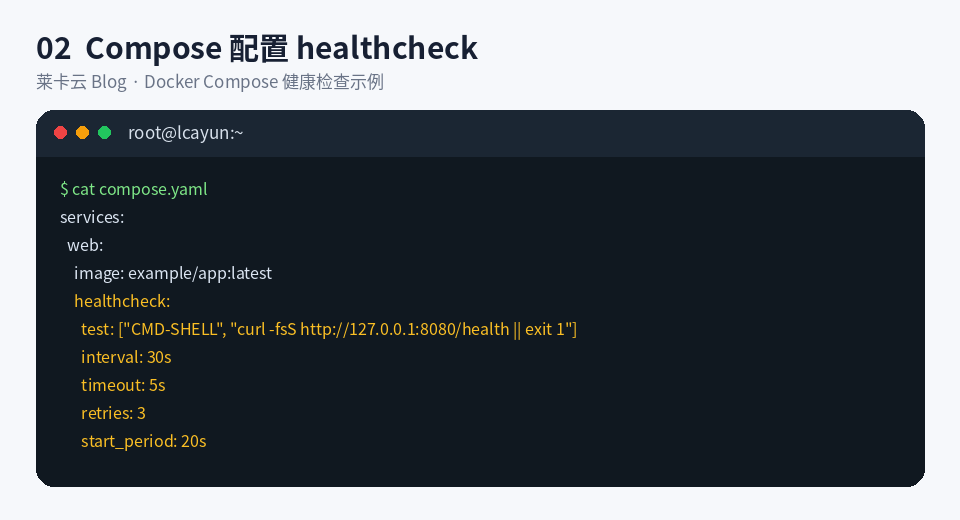
例如有一个 Web 应用监听:
8080
可以在 compose.yaml 中增加:
services:
  web:
    image: example/app:latest
    restart: unless-stopped
    ports:
      - "8080:8080"
    healthcheck:
      test: ["CMD-SHELL", "curl -fsS http://127.0.0.1:8080/health || exit 1"]
      interval: 30s
      timeout: 5s
      retries: 3
      start_period: 20s
这里的健康检查会在容器内部执行:
curl -fsS http://127.0.0.1:8080/health如果命令返回成功,Docker 会认为本次检查通过。
如果连续检查失败达到指定次数,就会将容器标记为:
unhealthy4. test 是什么意思?
test 是 healthcheck 最重要的配置。
例如:
test: ["CMD-SHELL", "curl -fsS http://127.0.0.1:8080/health || exit 1"]表示 Docker 定期执行这一条命令。
如果返回码为:
0通常表示检查成功。
非 0 返回码则表示失败。
因此 healthcheck 实际上就是:
Docker 定期在容器内部运行一个测试命令,并根据退出状态判断应用是否健康。
5. CMD 和 CMD-SHELL 有什么区别?
常见的写法之一是:
test: ["CMD", "curl", "-f", "http://127.0.0.1:8080/health"]这种方式直接执行命令。
另一种是:
test: ["CMD-SHELL", "curl -fsS http://127.0.0.1:8080/health || exit 1"]CMD-SHELL 会通过 Shell 执行,因此可以使用:
||
&&
管道;
变量;
其他 Shell 语法。
对于需要稍微复杂一点判断的健康检查,CMD-SHELL 通常更加方便。
6. interval 是什么意思?
例如:
interval: 30s表示 Docker 大约每隔 30 秒执行一次健康检查。
如果设置太短,例如:
1s可能会造成没有必要的额外请求和资源消耗。
普通 Web 应用可以根据实际情况使用:
10s
30s
60s
等。
没有必要所有项目都使用相同数值。
7. timeout 是什么意思?
例如:
timeout: 5s表示单次健康检查允许执行的最长时间。
如果应用在规定时间内没有完成检查,Docker 会将本次检查视为失败。
例如某个接口正常情况下:
100ms
就能够响应,那么 5s 已经比较宽松。
如果后端本身需要很长时间才能返回,则应该根据业务实际情况调整。
不要单纯为了让健康检查变成 healthy,就把 timeout 设置得特别长。
8. retries 是什么意思?
例如:
retries: 3表示健康检查连续失败达到一定次数以后,Docker 才会将容器标记为:
unhealthy这样可以避免因为:
瞬时网络波动;
数据库短暂繁忙;
应用偶发超时;
导致容器立刻进入 unhealthy。
如果应用本身对短暂失败比较敏感,可以根据实际情况调整次数。
9. start_period 有什么作用?
很多应用刚启动时需要一些初始化时间。
例如:
数据库加载;
缓存初始化;
Java 应用启动;
数据库迁移;
依赖服务连接。
如果容器刚启动几秒钟就开始严格进行健康检查,很容易出现:
应用还没准备好,Docker 就认为健康检查失败。
可以使用:
start_period: 20s为应用提供一段启动缓冲时间。
对于启动速度较慢的应用,这个配置非常有用。
10. 为什么配置 healthcheck 后一直 unhealthy?
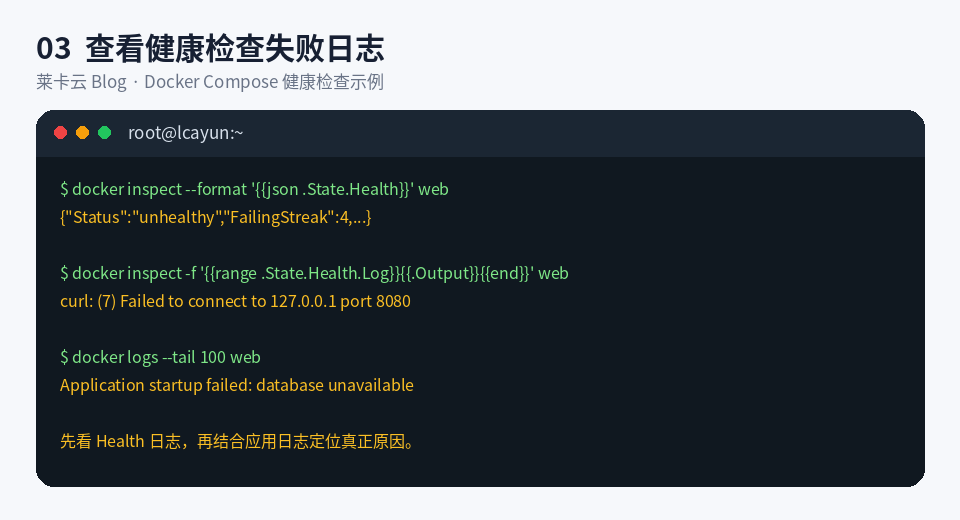
首先执行:
docker ps确认状态。
然后查看 Health 信息:
docker inspect 容器名称如果希望快速查看,可以执行:
docker inspect --format '{{json .State.Health}}' 容器名称例如可能看到:
"Status":"unhealthy"以及:
"FailingStreak":4这说明健康检查已经连续失败。
接下来应该继续查看每次 Healthcheck 的具体输出。
11. 查看 healthcheck 失败日志
可以执行:
docker inspect -f '{{range .State.Health.Log}}{{println .Output}}{{end}}' 容器名称例如可能看到:
curl: (7) Failed to connect to 127.0.0.1 port 8080说明健康检查命令无法访问本地 8080 服务。
此时应该继续检查:
程序是否启动;
端口是否正确;
应用是否只监听其他地址;
健康检查 URL 是否正确。
不要一看到 unhealthy 就直接重新创建容器。
12. healthcheck 命令必须存在于容器中
这是很容易踩坑的一点。
例如 healthcheck 配置:
test: ["CMD-SHELL", "curl -fsS http://127.0.0.1:8080/health || exit 1"]前提是:
容器镜像内部存在 curl。
如果镜像非常精简,内部根本没有:
curl那么健康检查一定失败。
可以进入容器检查:
docker exec -it 容器名称 sh执行:
which curl如果没有任何输出,就说明镜像可能没有安装 curl。
这时可以:
使用镜像已有的工具;
制作自己的 Dockerfile 安装需要的工具;
或者调整健康检查方式。
13. 使用 wget 做 HTTP 健康检查
部分 Alpine 或 BusyBox 环境可能包含 wget。
可以根据镜像实际情况使用:
healthcheck:
  test: ["CMD-SHELL", "wget -qO- http://127.0.0.1:8080/health >/dev/null 2>&1 || exit 1"]
  interval: 30s
  timeout: 5s
  retries: 3
但同样应该先确认:
which wget该工具确实存在于容器内部。
不要复制健康检查配置以后才发现容器里根本没有对应命令。
14. TCP 服务怎么做健康检查?
并不是所有服务都有 HTTP 接口。
例如某些数据库、缓存或者 TCP 服务,可以使用端口检查。
如果容器内部存在 nc,可以根据实际情况使用:
healthcheck:
  test: ["CMD-SHELL", "nc -z 127.0.0.1 3306 || exit 1"]
  interval: 30s
  timeout: 5s
  retries: 3
这里仅仅检测:
3306
端口能否建立连接。
但需要注意:
端口能连接,并不一定代表数据库业务逻辑完全正常。
对于 MySQL、PostgreSQL、Redis 等服务,如果镜像提供官方客户端命令,通常可以使用更准确的应用级健康检查。
15. MySQL 健康检查示例
例如 MySQL 可以根据项目实际配置使用:
services:
  mysql:
    image: mysql:8
    environment:
      MYSQL_ROOT_PASSWORD: ${MYSQL_ROOT_PASSWORD}
    healthcheck:
      test: ["CMD-SHELL", "mysqladmin ping -h 127.0.0.1 -uroot -p$$MYSQL_ROOT_PASSWORD --silent"]
      interval: 10s
      timeout: 5s
      retries: 5
      start_period: 30s
需要注意:
Compose 中:
$$和:
$的处理方式不同。
同时不要把真实数据库密码直接写进公开文章或代码仓库。
正式项目应该结合 .env 或其他凭据管理方案使用。
16. healthy 会自动重启 unhealthy 容器吗?
不会因为 healthcheck 变成:
unhealthy就必然自动重启容器。
healthcheck 的主要作用是:
提供容器健康状态。
而:
restart: unless-stopped主要针对容器主进程退出后的重启策略。
如果容器主进程还在运行,只是 healthcheck 失败,Docker 通常只是把容器标记为:
unhealthy不会把 healthcheck 当成“主进程退出”自动处理。
因此不要把:
restart
和:
healthcheck
理解成同一个功能。
17. healthcheck 有什么实际作用?
既然 unhealthy 不一定自动重启,那么 healthcheck 有什么用?
主要用途包括:
快速确认应用真实状态;
监控系统读取容器健康状态;
Docker Compose 控制服务依赖;
运维人员快速发现应用异常;
自动化平台根据健康状态进行后续处理。
例如执行:
docker ps一眼就可以看到:
(healthy)还是:
(unhealthy)比单纯看到:
Up 2 hours更有参考价值。
18. depends_on 和 healthcheck 怎么配合?
假设:
web
需要连接:
mysql
如果只配置:
depends_on:
  - mysql
通常主要表示启动顺序上的依赖关系。
但:
MySQL 容器已经启动,并不代表 MySQL 已经完成初始化,可以接受连接。
可以结合 healthcheck。
例如:
services:
  mysql:
    image: mysql:8
    environment:
      MYSQL_ROOT_PASSWORD: ${MYSQL_ROOT_PASSWORD}
    healthcheck:
      test: ["CMD-SHELL", "mysqladmin ping -h 127.0.0.1 -uroot -p$$MYSQL_ROOT_PASSWORD --silent"]
      interval: 10s
      timeout: 5s
      retries: 5
      start_period: 30s

  web:
    image: example/web:latest
    depends_on:
      mysql:
        condition: service_healthy
这样 Compose 在处理依赖时,可以等待 MySQL 达到 healthy 状态后再启动 Web 服务。
19. depends_on 能完全解决数据库启动顺序问题吗?
不能把所有可靠性都依赖在 Compose 启动顺序上。
即使 MySQL 启动时处于 healthy:
后续运行中数据库仍然可能重启;
网络可能短暂中断;
数据库可能出现异常;
连接可能超时。
因此真正可靠的 Web 应用本身也应该具备:
连接失败重试;
合理超时;
断线重连;
错误处理。
depends_on + service_healthy
更适合改善初次启动时的依赖顺序,而不是替代应用自身的容错机制。
20. Dockerfile 自带 HEALTHCHECK 怎么办?
部分 Docker 镜像本身可能已经包含:
HEALTHCHECK可以执行:
docker inspect 容器名称查看:
Healthcheck相关配置。
Docker Compose 中重新定义:
healthcheck:时,可以根据项目需要覆盖镜像默认健康检查。
但正式修改之前建议先了解镜像原本为什么设计该 Healthcheck。
不要看到默认 unhealthy 就直接把健康检查关闭。
21. 如何临时关闭镜像自带 healthcheck?
如果确实明确不需要镜像默认 Healthcheck,可以在 Compose 中根据实际情况禁用。
例如:
healthcheck:
  disable: true
但这种方式应该谨慎使用。
如果默认健康检查一直失败,更应该先确认:
应用是否真正正常;
检查命令是否适用于当前环境;
配置是否发生变化。
关闭 healthcheck 只会让:
unhealthy不再显示,并不会自动修复应用本身。
22. healthcheck 接口应该检查什么?
一个好的健康检查接口应该:
响应快;
依赖少;
能够真实反映应用是否可以提供基本服务;
不会执行大量计算;
不会修改业务数据。
例如:
/health或者:
/healthz通常只需要返回:
200 OK不建议 healthcheck 每 10 秒执行一次:
复杂数据库统计;
大文件操作;
第三方 API 请求;
耗时业务流程。
否则健康检查本身也可能给应用增加压力。
23. 健康检查应该检查数据库吗?
取决于业务。
如果 Web 应用没有数据库就完全无法提供服务,那么 Health API 可以适度检查数据库连接。
但如果把大量外部依赖全部加入健康检查:
Redis;
MySQL;
第三方支付;
外部 API;
对象存储;
只要任何一个服务暂时波动,整个容器就可能被标记 unhealthy。
因此应该根据实际业务区分:
应用进程是否存活;
应用是否基本可服务;
关键依赖是否可用。
不要让 Healthcheck 变得过于复杂。
24. 修改 healthcheck 后为什么没变化?
修改:
compose.yaml
以后,需要让 Docker 使用新的容器配置。
可以先验证:
docker compose config确认 Healthcheck 配置已经被正确解析。
然后执行:
docker compose up -d如果需要确保重新创建:
docker compose up -d --force-recreate再查看:
docker ps刚创建的容器可能先显示:
health: starting等待一段时间以后才会变成:
healthy或者:
unhealthy这是正常过程。
25. 如何查看最终 healthcheck 配置?
执行:
docker inspect -f '{{json .Config.Healthcheck}}' 容器名称可以看到当前容器实际使用的 Healthcheck 配置。
这样可以确认:
Test
Interval
Timeout
Retries
StartPeriod
是否符合预期。
如果 Compose 文件明明已经修改,但 inspect 还是旧配置,通常说明容器没有按照新配置重新创建。
26. 容器 unhealthy 但网站可以打开怎么办?
这种情况通常说明:
Healthcheck 本身写错了。
例如:
网站实际监听:
8080但 Healthcheck 检查:
80或者:
实际接口:
/health却检查:
/healthz也可能是:
容器中没有 curl;
DNS 名称错误;
接口需要认证;
检查地址绑定错误。
可以先进入容器,手工运行和 healthcheck 完全相同的命令。
例如:
docker exec -it web sh然后:
curl -fsS http://127.0.0.1:8080/health这样最容易发现检查命令本身的问题。
27. 容器 healthy 但外部还是打不开怎么办?
healthy
通常只说明:
容器内部的健康检查通过。
并不代表公网一定可以访问。
如果:
容器 healthy;
服务器本机访问正常;
公网打不开;
则应该继续检查:
Docker 端口映射;
服务器防火墙;
安全组;
Nginx 反向代理;
公网网络。
例如:
docker ps确认有没有:
0.0.0.0:8080->8080/tcp如果没有宿主机端口映射,外部可能无法直接访问。
28. Docker Compose 健康检查快速排查顺序
遇到 unhealthy 时,可以按照下面的顺序处理。
第一步:查看状态
docker ps第二步:查看 Health 信息
docker inspect --format '{{json .State.Health}}' 容器名称第三步:查看 Health 日志
docker inspect -f '{{range .State.Health.Log}}{{println .Output}}{{end}}' 容器名称第四步:查看应用日志
docker logs --tail 100 容器名称第五步:进入容器手工执行健康检查命令
docker exec -it 容器名称 sh第六步:检查 Compose
docker compose config第七步:修改以后重新创建
docker compose up -d --force-recreate按照这个顺序,通常可以判断是:
Healthcheck 配置错误;
检查工具缺失;
应用没有启动;
接口错误;
依赖服务异常。
29. Docker 项目部署建议
如果一台服务器运行多个 Docker Compose 项目,Healthcheck 可以帮助快速了解不同容器的实际运行状态。
如果还没有安装 Docker,可以参考:
安装教程: 服务器上安装docker和docker-compose教程
如果项目越来越多,希望通过 Web 页面统一管理 Compose Stack,可以参考:
相关阅读: 使用 Docker 搭建 Dockge:可视化管理 Docker Compose 项目
如果需要部署 Docker 网站、数据库、监控或其他自托管项目,也可以根据实际业务配置选择莱卡云 Linux 云服务器。
查看官网购买链接: https://www.lcayun.com
30. 总结
Docker 容器显示:
Up只说明容器主进程仍然运行,并不能完全说明应用真正可用。
通过 Docker Compose 配置:
healthcheck:可以定期检查应用状态。
最常用的配置包括:
test
interval
timeout
retries
start_period
出现:
unhealthy以后,应该优先查看:
docker inspect --format '{{json .State.Health}}' 容器名称再结合:
docker logs --tail 100 容器名称判断问题。
如果存在数据库等启动依赖,还可以配合:
depends_on:
  mysql:
    condition: service_healthy
改善 Compose 项目启动顺序。
需要特别注意:
unhealthy 本身并不等于 Docker 会自动重启容器。
Healthcheck 的核心作用是帮助 Docker、Compose 和运维人员判断:
容器中的应用是否真正处于健康状态。